版权申明:本站为公益科普网站,版权归原作者所有,如有侵权,请联系我们
发布时间:2026-09-17 来源:
你是否遇到过这样的场景:对着电视说“播放《甄嬛传》”,它能迅速响应;但换成“帮我找刘德华演的粤语警匪片”,它却开始“犯迷糊”;继续追问“就放刚才推荐的第二部”,甚至可能直接跳回首页。
这几句话看似都在找内容,背后的表达难度却完全不同:有的直接说片名,有的叠加演员、类型和语言条件,还有的省略了关键信息,需要结合上下文才能理解。
智能设备能否听懂这些“人话”,不仅取决于模型有多聪明,还取决于它见过多少真实、多样的表达。今天,我们就来拆解一项藏在智能交互背后的基础技术:利用大模型生成自然语言交互语料。
1、痛点:标准指令听得懂,换个说法就“犯迷糊”
传统语料主要依靠人工编写或模板扩充。例如,以“播放《甄嬛传》”为标准句,只需替换片名,就能快速生成大量指令。
这种方法效率不低,却容易陷入“换词不换骨”的困境:句式高度相似,表达过于标准,复杂条件、模糊描述和上下文省略覆盖不足。
而真实用户很少按照模板说话。有人会说“找一下刘德华演的粤语警匪片”,有人会说“有没有粤语的”,也有人只说“还是刚才那个”。如果语料库里只有标准答案,智能设备就像一个背熟题库却不会变通的考生,题目稍微换个问法,就可能答不上来。
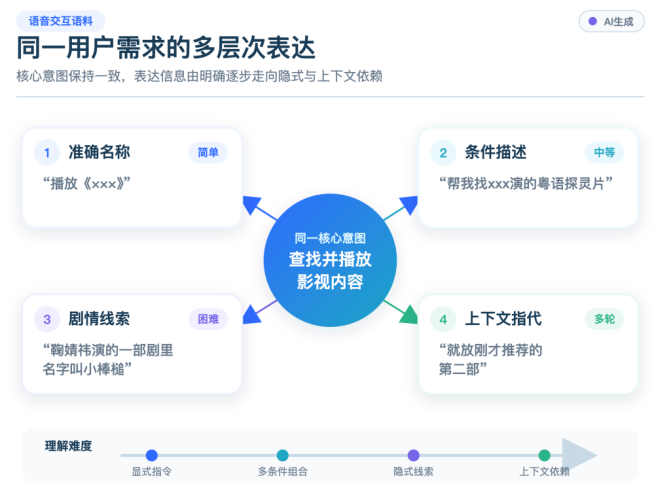
【图1 同一用户需求的多层次表达示意图】
2、破局:给大模型一份“事实底稿”和一把“难度尺”
大模型擅长语言变化,但如果任其过度自由发挥,也可能编造不存在的演员、剧情或节目。因此,生成高质量语料不能只告诉模型“多写几句话”,还要给它两样东西。
第一样是“事实底稿”。系统从内容资源库中提取片名、类型、演员、角色、剧情、语言和地区等信息,再将这些真实属性提供给大模型。这样,模型生成的每句话都有事实依据,而不是凭空想象。
第二样是“难度尺”。根据交互复杂度,可将语料分成不同层级:
①简单表达:直接说出内容名称,如“播放《甄嬛传》”。
②条件组合:叠加演员、类型或语言,如“帮我找刘德华演的粤语警匪片”。
③隐式表达:使用角色或剧情线索,如“鞠婧祎演的一部剧里名字叫小棒槌”。
④多轮表达:结合上下文追问,如“有没有粤语的”“就看第二个”。
大模型不再只是机械替换关键词,而是重新组织语序、增减信息、模拟口语习惯,并生成不同难度的表达。这种方式可以概括为:基于真实数据进行“有边界的创造”。
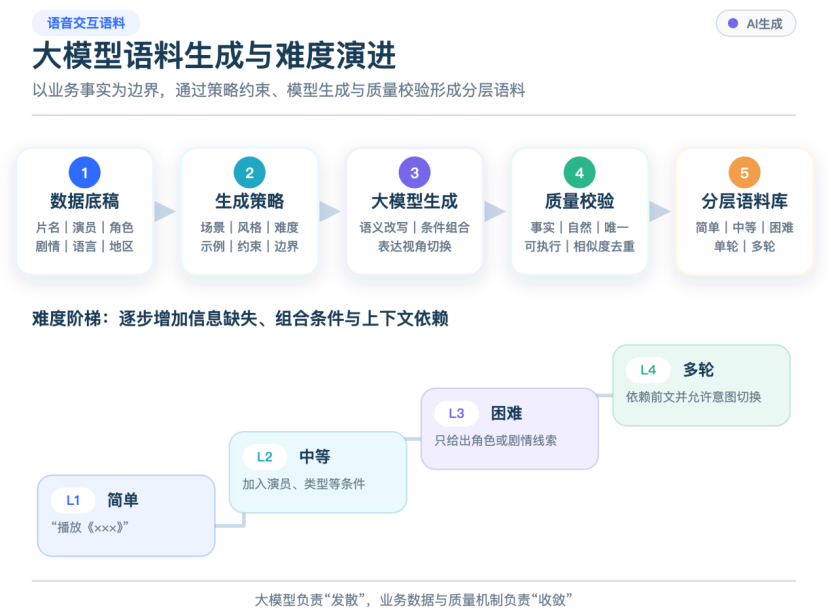
【图2 大模型语料生成与难度演进流程图】
3、把关:高质量语料要过三道“质量闸门”
会生成只是第一步,生成得“对”才有实际价值。一条语料进入系统前,至少要经过三道检查。
①事实关
演员、角色、语言和剧情是否与资源数据一致,避免出现张冠李戴。
②表达关
句子是否自然、口语化,能不能像真实用户会说的话,而不是把数据库字段生硬地拼在一起。
③业务关
这句话能否被系统识别和执行,结果是否唯一;如果存在多个候选,系统能否进入合理的澄清流程。
实际处理中,可以先用规则检查实体、长度和敏感内容,再通过资源检索验证事实,利用语义相似度聚类去除重复表达,最后结合模型评分与人工抽检处理复杂样本。
值得注意的是,生成模型不宜同时担任唯一的“裁判”。多种校验方式相互配合,才能避免模型对自己的答案“既当运动员,又当裁判员”。
4、落地:让语料从文本走进真实交互
文本写得自然,并不代表设备一定听得懂。语音交互还要经过语音识别、语义理解、内容检索和业务执行等多道环节。
因此,生成的文本语料还可以通过语音合成技术,转换成不同音色、语速和语气的音频,并叠加适量环境噪声,模拟客厅、卧室等真实使用场景。
这些音频进入终端后,系统依次完成“听见—理解—查找—执行”,再记录是否识别正确、是否找到目标内容、是否需要澄清,以及最终页面是否符合预期。
失败样本则会重新回到语料生成环节:识别错误的补充发音变化,理解错误的增加相似表达,检索失败的完善资源标签。
整个过程形成了一条完整链路:资源信息获取 → 文本语料生成 → 质量自动校验 → 语音合成 → 终端交互 → 结果反馈。
5、结语:从“听见指令”到“听懂用户”
大模型语料生成的价值,不只是一次批量造句,而是把内容数据、语言生成、质量校验和终端反馈连接成一座持续运转的“语料工厂”。
它的价值并不只是替代人工多写几句话,而是帮助我们系统地覆盖那些容易被忽略的表达:没有完整名称的模糊描述、隐藏在语气中的真实意图、依赖上下文的连续追问,以及随时可能发生的需求变化。
技术的目标不是让用户学会如何向机器下指令,而是让机器逐渐适应人的自然表达。当智能设备能够理解省略、模糊和上下文中的真实意图,人机交互才能真正从“听见指令”走向“听懂用户”。
作者:蒋晔
单位:中国移动杭州研发中心


发布时间:2026-09-17 来源:
你是否遇到过这样的场景:对着电视说“播放《甄嬛传》”,它能迅速响应;但换成“帮我找刘德华演的粤语警匪片”,它却开始“犯迷糊”;继续追问“就放刚才推荐的第二部”,甚至可能直接跳回首页。
这几句话看似都在找内容,背后的表达难度却完全不同:有的直接说片名,有的叠加演员、类型和语言条件,还有的省略了关键信息,需要结合上下文才能理解。
智能设备能否听懂这些“人话”,不仅取决于模型有多聪明,还取决于它见过多少真实、多样的表达。今天,我们就来拆解一项藏在智能交互背后的基础技术:利用大模型生成自然语言交互语料。
1、痛点:标准指令听得懂,换个说法就“犯迷糊”
传统语料主要依靠人工编写或模板扩充。例如,以“播放《甄嬛传》”为标准句,只需替换片名,就能快速生成大量指令。
这种方法效率不低,却容易陷入“换词不换骨”的困境:句式高度相似,表达过于标准,复杂条件、模糊描述和上下文省略覆盖不足。
而真实用户很少按照模板说话。有人会说“找一下刘德华演的粤语警匪片”,有人会说“有没有粤语的”,也有人只说“还是刚才那个”。如果语料库里只有标准答案,智能设备就像一个背熟题库却不会变通的考生,题目稍微换个问法,就可能答不上来。
【图1 同一用户需求的多层次表达示意图】
2、破局:给大模型一份“事实底稿”和一把“难度尺”
大模型擅长语言变化,但如果任其过度自由发挥,也可能编造不存在的演员、剧情或节目。因此,生成高质量语料不能只告诉模型“多写几句话”,还要给它两样东西。
第一样是“事实底稿”。系统从内容资源库中提取片名、类型、演员、角色、剧情、语言和地区等信息,再将这些真实属性提供给大模型。这样,模型生成的每句话都有事实依据,而不是凭空想象。
第二样是“难度尺”。根据交互复杂度,可将语料分成不同层级:
①简单表达:直接说出内容名称,如“播放《甄嬛传》”。
②条件组合:叠加演员、类型或语言,如“帮我找刘德华演的粤语警匪片”。
③隐式表达:使用角色或剧情线索,如“鞠婧祎演的一部剧里名字叫小棒槌”。
④多轮表达:结合上下文追问,如“有没有粤语的”“就看第二个”。
大模型不再只是机械替换关键词,而是重新组织语序、增减信息、模拟口语习惯,并生成不同难度的表达。这种方式可以概括为:基于真实数据进行“有边界的创造”。
【图2 大模型语料生成与难度演进流程图】
3、把关:高质量语料要过三道“质量闸门”
会生成只是第一步,生成得“对”才有实际价值。一条语料进入系统前,至少要经过三道检查。
①事实关
演员、角色、语言和剧情是否与资源数据一致,避免出现张冠李戴。
②表达关
句子是否自然、口语化,能不能像真实用户会说的话,而不是把数据库字段生硬地拼在一起。
③业务关
这句话能否被系统识别和执行,结果是否唯一;如果存在多个候选,系统能否进入合理的澄清流程。
实际处理中,可以先用规则检查实体、长度和敏感内容,再通过资源检索验证事实,利用语义相似度聚类去除重复表达,最后结合模型评分与人工抽检处理复杂样本。
值得注意的是,生成模型不宜同时担任唯一的“裁判”。多种校验方式相互配合,才能避免模型对自己的答案“既当运动员,又当裁判员”。
4、落地:让语料从文本走进真实交互
文本写得自然,并不代表设备一定听得懂。语音交互还要经过语音识别、语义理解、内容检索和业务执行等多道环节。
因此,生成的文本语料还可以通过语音合成技术,转换成不同音色、语速和语气的音频,并叠加适量环境噪声,模拟客厅、卧室等真实使用场景。
这些音频进入终端后,系统依次完成“听见—理解—查找—执行”,再记录是否识别正确、是否找到目标内容、是否需要澄清,以及最终页面是否符合预期。
失败样本则会重新回到语料生成环节:识别错误的补充发音变化,理解错误的增加相似表达,检索失败的完善资源标签。
整个过程形成了一条完整链路:资源信息获取 → 文本语料生成 → 质量自动校验 → 语音合成 → 终端交互 → 结果反馈。
5、结语:从“听见指令”到“听懂用户”
大模型语料生成的价值,不只是一次批量造句,而是把内容数据、语言生成、质量校验和终端反馈连接成一座持续运转的“语料工厂”。
它的价值并不只是替代人工多写几句话,而是帮助我们系统地覆盖那些容易被忽略的表达:没有完整名称的模糊描述、隐藏在语气中的真实意图、依赖上下文的连续追问,以及随时可能发生的需求变化。
技术的目标不是让用户学会如何向机器下指令,而是让机器逐渐适应人的自然表达。当智能设备能够理解省略、模糊和上下文中的真实意图,人机交互才能真正从“听见指令”走向“听懂用户”。
作者:蒋晔
单位:中国移动杭州研发中心